ラベル Twitter の投稿を表示しています。 すべての投稿を表示

2022年12月30日金曜日

PythonとTwitter API v2でリアルタイムにツイートを取得する

Twitter API v1.1のリアルタイムのツイート収集が使えなくなったので、API v2に移行した。PythonライブラリのTweepyとTwitter API v2でリアルタイムにツイート収集する方法をまとめておく。


環境

WSL2(Ubuntu20.04)。

$ lsb_release -dr
Description:    Ubuntu 20.04.5 LTS
Release:        20.04
$ python3 -V
Python 3.8.10
$ pip3 show tweepy
Name: tweepy
Version: 4.12.1
...


Twitter API のBearer Tokenの取得

Twitter API v2でリアルタイムにツイートを収集するために、Twitterの開発者サイトでBearer Tokenを取得しておく。開発者サイトのProjects & Apps > Overviewの画面で、対象アプリの[Keys and tokens](鍵のアイコン)を開く。この画面でBearer Tokenを生成できる。


Tweepyでリアルタイムツイート取得

TweepyでTwitter API v2を使ってリアルタイムにツイートを収集するには、StreamingClientクラスを使う。v1.1のとき(Tweepy4でリアルタイムツイートを取得する)と同様に、このクラスを継承したクラスを作成する。以下のコードでは、Twitter API v2のsampleメソッドを使って、リアルタイムに1%のツイートを出力する。

import tweepy

# Twitter APIの認証情報
# Twitterの開発者向けページで取得したBearer Tokenを使う
BEARER_TOKEN = 'Bearer Token'

class TwStream(tweepy.StreamingClient):
    def on_tweet(self, tweet):
        print('-------------------------')
        print(tweet.data)

def main():
    twstream = TwStream(BEARER_TOKEN)
    twstream.sample()

if __name__ == '__main__':
    main()

ただ、このコードで取得できるのはツイートのIDやテキストのみで、取得できるデータはv1.1のときと違ってかなり限定されている。v2では、取得する情報を指定する必要がある。


APIで取得対象のデータを指定する

Twitter API v2では、ExpansionsとFieldsを指定することで、さまざまなデータを取得できる。以下のコードでは、ExpansionsとTweetフィールド、Userフィールドを指定。

import tweepy

# Twitter APIの認証情報
# Twitterの開発者向けページで取得したBearer Tokenを使う
BEARER_TOKEN = 'Bearer Token'

class TwStream(tweepy.StreamingClient):
    def on_tweet(self, tweet):
        print('-------------------------')
        print(tweet.data)

def main():
    twstream = TwStream(BEARER_TOKEN)
    # 取得するExpansions
    expansions = ['author_id', 'referenced_tweets.id', 'attachments.media_keys']
    # 取得するTweetフィールド
    tweet_fields = ['author_id', 'created_at', 'attachments', 'lang', 'public_metrics']
    # 取得するUserフィールド
    user_fields = ['created_at', 'description', 'location', 'verified']
    twstream.sample(expansions=expansions, tweet_fields=tweet_fields, user_fields=user_fields)

if __name__ == '__main__':
    main()

上記のように取得データを指定できるが、v1.1のように言語の指定ができない。このままだと、英語やさまざまな言語のツイートが混ざって取得される。filterメソッドを使うと言語の指定ができるが、filterメソッドでは取得できるツイート数に制限があるので、大量のツイートを収集したい場合には使えない。日本語で絞りたい場合は次のようなコードになる。取得したTweetオブジェクトのlangフィールドを参照して、日本語(ja)のみに限定する。

import tweepy

# Twitter APIの認証情報
# Twitterの開発者向けページで取得したBearer Tokenを使う
BEARER_TOKEN = 'Bearer Token'

class TwStream(tweepy.StreamingClient):
    def on_tweet(self, tweet):
        if tweet.lang == 'ja':
            print('-------------------------')
            print(tweet.data)

def main():
    twstream = TwStream(BEARER_TOKEN)
    # 取得するExpansions
    expansions = ['author_id', 'referenced_tweets.id', 'attachments.media_keys']
    # 取得するTweetフィールド
    tweet_fields = ['author_id', 'created_at', 'attachments', 'lang', 'public_metrics']
    # 取得するUserフィールド
    user_fields = ['created_at', 'description', 'location', 'verified']
    twstream.sample(expansions=expansions, tweet_fields=tweet_fields, user_fields=user_fields)

if __name__ == '__main__':
    main()


2022年9月26日月曜日

Twitter Streaming APIのfilterは日本語に対応していない

Twitter Streaming APIではリアルタイムにツイートを取得できる。sampleとfilterの2種類の機能があるが、filterではキーワードを指定することで、このキーワードを含むツイートを取得することができる。と思っていたのだが、実際にfilterを使ってツイートを収集してみると、期待通りのツイートが取得できていない。

実際にキーワードを指定して収集してみる。以下コードはTwitter Streaming APIで省略されていないツイートテキストを取得するのコードを変更して、filterでキーワード「スイーツ」を指定したもの。これにより、「スイーツ」を含むツイートが取得できることを期待している。

import tweepy

# Twitter APIの認証情報
# Twitterの開発者向けのページで取得したキーとトークンを使う
CONSUMER_KEY = 'Consumer Key'
CONSUMER_SECRET = 'Consumer Secret'
ACCESS_TOKEN = 'Access Token'
ACCESS_TOKEN_SECRET = 'Access Token Secret'

class TwStream(tweepy.Stream):
    def _get_text(self, status):
        # 拡張ツイートの場合
        if hasattr(status, 'extended_tweet'):
            return status.extended_tweet['full_text']
        else:
            return status.text

    def on_status(self, status):
        # status(APIで取得できるデータ)を受け取ったときにon_statusが実行される
        print('-------------------------')
        # リツイートの場合は「RT」+ メンション分だけ文字数オーバーするので省略されることがある
        if hasattr(status, 'retweeted_status'):
            text = self._get_text(status.retweeted_status)
        else:
            text = self._get_text(status)
        # スクリーンネームとツイートを表示
        print(f'@{status.author.screen_name} {text}')

def main():
    twstream = TwStream(CONSUMER_KEY, CONSUMER_SECRET, ACCESS_TOKEN, ACCESS_TOKEN_SECRET)

    # キーワード「スイーツ」を指定してツイートを取得
    twstream.filter(track=['スイーツ'], languages=['ja'])

if __name__ == '__main__':
    main()

実際に取得できたツイートすべてに「スイーツ」が含まれるが、よくよくみるとハッシュタグ「#スイーツ」や「スイーツ」のあとに空白があるツイートのみしか取得できていない。Twitterで「スイーツ」で検索した結果と比べてみても、それが確認できる。

Twitter APIの仕様を確認すると、Standard streaming API request parametersには以下の一文がある。

Non-space separated languages, such as CJK are currently unsupported.

つまり、filterでは日本語などの単語がスペースで区切られていない言語は未サポートということ。キーワードとして「スイーツ」を指定した場合、スイーツの直後にスペースがあるハッシュタグは取得できるが、ツイートテキスト内に「スイーツ」があっても取得対象にならない。過去のツイートを取得できるSearch APIでは、キーワード「スイーツ」を指定して「スイーツ」を含むツイートを取得できるが、Streaming APIでは同様のことはできないようだ。

Stream APIのfilterで日本語を使う場合は、特定のハッシュタグを含むツイートを取得する場合など、限定的な使い方になりそう。


2022年9月18日日曜日

Twitter Streaming APIで省略されていないツイートテキストを取得する

Twitter Streaming APIでツイートテキストを取得するときに、省略されていないテキスト全文を取得する方法をまとめておく。


環境

WSL2(Ubuntu20.04)。

$ lsb_release -dr
Description:    Ubuntu 20.04.5 LTS
Release:        20.04
$ python3 -V
Python 3.8.10


省略されていないテキストを取得する方法

Twitter Streaming APIでツイートテキストを収集する場合、レスポンスデータのtextフィールドに、最大140文字までのテキストが格納されている。

ただし、2017年に半角文字の言語では280文字までに文字数制限が拡張されたために、ツイートテキストが140文字を超える場合がある。ツイートテキストが140文字を超える場合、textフィールドの最後が三点リーダー(…)となり、テキストの一部が省略されてしまう。

拡張された文字数のツイートテキストを取得するには、extended_tweetフィールドを使う。このextended_tweetフィールドはツイートテキストの文字数が140文字を超えた場合に存在し、このフィールドのfull_textフィールドにツイートテキストが格納されている。

ただこれでもまだ省略されてしまう場合がある。それはリツイートの場合で、ツイートテキストにRTとメンションが付与されるので、元のツイートが文字数制限いっぱいだと、ツイートテキストは一部省略されてしまう。

リツイートの場合、レスポンスデータのextended_tweetフィールドに元ツイートの情報があるので、そのツイートテキストを取得することで、省略されていないテキストを取得することができる。


省略されていないテキストを取得するコード

上記をふまえて、PythonでTwitter Streaming APIのレスポンスから省略されていないツイートテキスト全文を取得するコードを作成する。Twitter Streaming APIのデータ取得には、PythonライブラリのTweepyを使う。TweepyでStreaming APIを使う方法はTweepy4でリアルタイムツイートを取得するを参照。以下はStreaming APIでランダムサンプリングを取得して、スクリーンネームとツイートテキストを表示するコード。

import tweepy

# Twitter APIの認証情報
# Twitterの開発者向けのページで取得したキーとトークンを使う
CONSUMER_KEY = 'Consumer Key'
CONSUMER_SECRET = 'Consumer Secret'
ACCESS_TOKEN = 'Access Token'
ACCESS_TOKEN_SECRET = 'Access Token Secret'

class TwStream(tweepy.Stream):
    def _get_text(self, status):
        # 拡張ツイートの場合
        if hasattr(status, 'extended_tweet'):
            return status.extended_tweet['full_text']
        else:
            return status.text

    def on_status(self, status):
        # status(APIで取得できるデータ)を受け取ったときにon_statusが実行される
        print('-------------------------')
        # リツイートの場合は「RT」+ メンション分だけ文字数オーバーするので省略されることがある
        if hasattr(status, 'retweeted_status'):
            text = self._get_text(status.retweeted_status)
        else:
            text = self._get_text(status)
        # スクリーンネームとツイートを表示
        print(f'@{status.author.screen_name} {text}')

def main():
    twstream = TwStream(CONSUMER_KEY, CONSUMER_SECRET, ACCESS_TOKEN, ACCESS_TOKEN_SECRET)

    # 日本語ツイートに限定してランダムサンプリングを取得
    twstream.sample(languages=['ja'])

if __name__ == '__main__':
    main()


2022年1月10日月曜日

Pythonで絵文字のワードクラウドを作成する

PythonではWordcloudを使うと簡単にワードクラウドを作成できる(Pythonで国会会議録からワードクラウドを作成する)。ワークラウドは文章中のに出現する単語をその出現数などに応じて大きさなどを変えて配置するものだが、今回は絵文字だけを使ったワードクラウド(絵文字クラウド)を作成してみる。


環境

WSL2(Ubuntu20.04)。

$ lsb_release -dr
Description:    Ubuntu 20.04.3 LTS
Release:        20.04
$ python3 -V
Python 3.8.10


データの収集

絵文字クラウドを作成するには絵文字を含むテキストが必要になる。そこでTwitter APIを利用してツイートを収集する。今回はTweepy4でリアルタイムツイートを取得するのようにTweepyを利用する。以下コードでツイートのランダムサンプリングを1000件取得してpickle形式で保存しておく。

import pickle

import tweepy

# Twitter APIの認証情報
# Twitterの開発者向けのページで取得したキーとトークンを使う
CONSUMER_KEY = 'Consumer Key'
CONSUMER_SECRET = 'Consumer Secret'
ACCESS_TOKEN = 'Access Token'
ACCESS_TOKEN_SECRET = 'Access Token Secret'

# 取得するツイート数
TWEET_COUNT = 1000

# 取得したツイートを保存するパス
PKL_PATH = './tweet.pkl'


class TwStream(tweepy.Stream):
    texts = []

    def on_status(self, status):
        # status(APIで取得できるデータ)を受け取ったときにon_statusが実行される
        print('-------------------------')
        # スクリーンネームとツイートを表示
        print(f'{len(self.texts)} @{status.author.screen_name} {status.text}')

        self.texts.append(status.text)

        if len(self.texts) >= TWEET_COUNT:
            self.disconnect()


def main():
    twstream = TwStream(
        CONSUMER_KEY,
        CONSUMER_SECRET,
        ACCESS_TOKEN,
        ACCESS_TOKEN_SECRET
    )

    # 日本語ツイートに限定してランダムサンプリングを取得
    twstream.sample(languages=['ja'])

    with open(PKL_PATH, 'wb') as f:
        pickle.dump(twstream.texts, f)


if __name__ == '__main__':
    main()


必要なモジュールなどのインストール

絵文字クラウドの作成に必要なPythonモジュールなどをインストールする。

$ pip3 install wordcloud emoji

$ pip3 list | grep -e wordcloud -e emoji
emoji                    1.2.0
wordcloud                1.8.1


絵文字クラウドの作成

準備ができたので絵文字クラウドを作成する。保存したツイートからから絵文字を抽出して絵文字ごとの出現頻度を集計し、ワードクラウドを作成する。ただし、pngなどの画像に保存するとフォントが表示されない絵文字があるのでSVGで保存する。

import pickle
from collections import Counter

from wordcloud import WordCloud
import emoji

# 取得したツイートを保存したパス
PKL_PATH = './tweet.pkl'

# 最小絵文字頻度
MIN_COUNT = 3


def extract_emojis(text):
    # テキストから絵文字を抽出
    return [c for c in text if c in emoji.UNICODE_EMOJI['en']]


def counter(texts):
    # 絵文字がないテキストを除外
    col = [Counter(t) for t in texts if len(t) > 0]

    # 各テキストの絵文字数を合計
    return sum(col, Counter())


def load_tweets():
    with open(PKL_PATH, 'rb') as f:
        texts = pickle.load(f)

    print(f'len={len(texts)}')
    return texts


def create_word_cloud(features):
    # 絵文字クラウドの作成
    wordcloud = WordCloud(
        background_color='white',
        width=300,
        height=300,
        max_font_size=200
    )
    wordcloud.generate_from_frequencies(frequencies=features)

    # 絵文字クラウドを保存
    # pngなどの画像に直接保存するとフォントが正常に表示されない絵文字があるのでSVGで保存
    # wordcloud.to_file("./emojicloud.png")
    wordcloud_svg = wordcloud.to_svg(embed_font=True)
    with open('./emojicloud.svg', 'w') as f:
        f.write(wordcloud_svg)


def main():
    texts = load_tweets()
    emojis = [extract_emojis(t) for t in texts]
    emoji_freq = counter(emojis)

    # 出現頻度MIN_COUNT以上に制限
    features = {term: cnt for term, cnt in emoji_freq.items() if cnt >= MIN_COUNT}
    print(features)

    create_word_cloud(features)


if __name__ == '__main__':
    main()

作成したSVGをWindowsのChrome、Firefoxで表示するとそれぞれ以下の通り。フォントが違うのか微妙な違いがある。


2021年12月20日月曜日

Tweepy4でリアルタイムツイートを取得する

Twitter API v1.1でのリアルタイムツイート取得ができなくなっているので、この記事の方法は使えない。リアルタイムにツイートを取得するときは、PythonとTwitter API v2でリアルタイムにツイートを取得するのようにv2を使う。(2022.12.30追記)


 TweepyはTwitter APIを利用してツイート検索などを行えるPythonライブラリ。バージョンが3から4になって仕様がけっこう変わっている。今回はTweepyの最新バージョン4でリアルタイムツイートを収集してみる。


環境

WSL2(Ubuntu20.04)。

$ lsb_release -dr
Description:    Ubuntu 20.04.3 LTS
Release:        20.04
$ python3 -V
Python 3.8.10

Twitter APIの利用に必要なAPIキーやトークンなどが未取得であれば、Twitterの開発者向けサイト(Developer Platform)で取得しておく。


Tweepyのインストール

Tweepyはpipでインストールできる。

$ pip3 install tweepy
$ pip3 show tweepy
Name: tweepy
Version: 4.4.0
Summary: Twitter library for Python
...


Tweepyでリアルタイムにツイートを取得する

Tweepyバージョン3でリアルタイムにツイートを取得するには、StreamListenerを継承するクラスのインスタンスをStreamオブジェクトにわたすようにしていたが、バージョン4ではStreamListenerが廃止されている。TweepyドキュメントのFrequently Asked QuestionsにStreamListener廃止についての記載がある。

Tweepyバージョン4でリアルタイムにツイートを取得するには、Streamを継承するクラスを作成し、そのインスタンスを使う。以下のコードではリアルタイムに日本語ツイートのランダムサンプリングを表示する。

import tweepy

# Twitter APIの認証情報
# Twitterの開発者向けのページで取得したキーとトークンを使う
CONSUMER_KEY = 'Consumer Key'
CONSUMER_SECRET = 'Consumer Secret'
ACCESS_TOKEN = 'Access Token'
ACCESS_TOKEN_SECRET = 'Access Token Secret'

class TwStream(tweepy.Stream):
    def on_status(self, status):
        # status(APIで取得できるデータ)を受け取ったときにon_statusが実行される
        print('-------------------------')
        # スクリーンネームとツイートを表示
        print(f'@{status.author.screen_name} {status.text}')

def main():
    twstream = TwStream(
        CONSUMER_KEY,
        CONSUMER_SECRET,
        ACCESS_TOKEN,
        ACCESS_TOKEN_SECRET
    )

    # 日本語ツイートに限定してランダムサンプリングを取得
    twstream.sample(languages=['ja'])

if __name__ == '__main__':
    main()


2021年1月12日火曜日

KH Coderでぴえんツイートを分析する2

KH Coderでぴえんツイートを分析するでは「今年の新語 2020」の大賞に選ばれた「ぴえん」を含むツイートをKH Coderで分析して大辞林の「ぴえん」の説明と比較してみた。今回はツイートされた時間帯に注目してKH Coderで分析してみる。ちなみに大辞林の「ぴえん」の説明は次の通り。

(若者言葉で)軽度の悲しみや落胆、また喜びや感激の気持ちを表す語。


環境


Windows10 Pro Version 2004
Windows版 KH Coder Version 3.Beta.01g
形態素解析器はMeCabで辞書としてmecab-ipadic-neologdを使用


分析対象のツイート


Twitter APIで収集した「ぴえん」を含むツイート(リツイート除く)で、期間は12月5日~12月11日の1週間。ここではKH Coderでぴえんツイートを分析するの再分析を行ったときと同じ状態で分析を行う。つまり、特定のツイートを除外したり、いくつかの語を強制抽出したりしている。

KH Coderで読み込むツイートはCSVとして保存してあり、1時、2時などの時間帯情報の列(hour)もある。時間帯ごとのツイート数は以下の通り(%は全体に占める割合)。

*0時 6194 5.74%
*1時 3634 3.36%
*2時 2126 1.97%
*3時 1284 1.19%
*4時   761       0.70%
*5時   689       0.64%
*6時 1090 1.01%
*7時 2286 2.12%
*8時 2632 2.44%
*9時 2678 2.48%
*10時 3078 2.85%
*11時 3489 3.23%
*12時 4949 4.58%
*13時 4197 3.89%
*14時 3846 3.56%
*15時 4405 4.08%
*16時 5075 4.70%
*17時 6287 5.82%
*18時 7265 6.73%
*19時 7890 7.31%
*20時 8408 7.79%
*21時 8694 8.05%
*22時 9024 8.36%
*23時 8020 7.43%

KH Coderで分析


今回はKH Coderで対応分析を行った。「抽出語×外部変数」では1時間ごとの時間帯を外部変数として指定した。さらに「最小出現数」と「最小文書数」は同数とし、対象が80語以上になるようにした上で、差異が顕著な上位80語を分析に使用した。以下は原点付近を拡大した結果。

0~23時の時間帯がほぼ時計回りに並んでいる。時間帯によってツイート内容が違っていると考えてよさそう。1日のうちでツイート数の多い21時、22時付近にはより多くの語が配置されている。

続いて、時間帯ごとの特徴語を出力してみる。KH Coderで読み込んだCSVに「hour」という時間帯の列があるとして、[ツール]>[外部変数と見出し]で「hour」列を選択して「特徴語」ボタンを押すと時間帯ごとの特徴語をExcelやCSVで出力できる。以下は12時台から23時台までの特徴語(数値はJaccard係数)。


昼間は「仕事」が特徴語になっている時間帯が多い。仕事に関係したツイートで「ぴえん」が使われることが多いのかもしれない。夜間は「ありがとう」が特徴語になっているが、大辞林の説明で言うところの喜びや感激の気持ちを表しているのだろうか。

2020年12月27日日曜日

KH Coderでぴえんツイートを分析する

三省堂が選んだ「今年の新語 2020」の大賞に「ぴえん」が選ばれた。

「今年の新語 2020」の選考結果

4種類の辞書の説明が掲載されているが、そのうちの大辞林の説明は次のようになっている。

(若者言葉で)軽度の悲しみや落胆、また喜びや感激の気持ちを表す語。

今回はTwitterのデータをKH Coderで分析して、Twitter上の「ぴえん」の使われ方と大辞林の説明を比較してみる。


環境


Windows10 Pro Version 2004
Windows版 KH Coder Version 3.Beta.01g
形態素解析器はMeCabで辞書としてmecab-ipadic-neologdを使用


分析対象のツイート


対象はTwitter APIで収集した「ぴえん」を含むツイート(リツイート除く)で、期間は12月5日~12月11日の1週間。多数投稿するユーザーのツイートを除外するために収集期間に8回以上投稿したユーザーのツイートを除外した(8回に特別な理由はないが、中央値は1なので投稿1回のユーザーが多い)。ちなみにツイート数上位10ユーザーの投稿数は次の通りで、中には1000を超えるユーザーもいた。

1326
128
116
90
76
73
60
54
42
40

さらに、ツイートからURL、@ではじまるユーザーネーム、絵文字を除去した。最終的な対象ツイートは109660件で、日ごとのツイート数は次の通り。

12/05 16669
12/06 16142
12/07 15257
12/08 14825
12/09 15686
12/10 15581
12/11 15500

ツイートの収集や集計などはPythonで行っているが詳細は省略。


KH Coderで分析

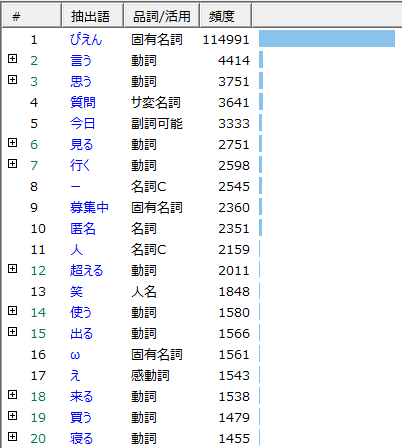
まずは抽出語を確認。もちろん「ぴえん」は圧倒的な最上位にある。

次に共起ネットワークを作成した。設定では「最小出現数」と「最小文書数」は同数とし、対象が80語以上になるようにした上で、上位80語を使用した。


赤枠の箇所では「ぱおん」や「ぴえんこえてぱおん」「ぴえんヶ丘どすこい之助」という「ぴえん」の上位語? らしいが出現している。mecab-ipadic-neologdを使ってもこれらは認識できなかったようだ。これらの語は後の再分析でKH Coderで強制的に語として抽出できるようにする。

オレンジ枠では、Peing(Twitterで利用できる質問サービス)を利用した投稿とDMを募集する投稿が多くを占めている。それぞれ「みんなからの匿名質問を募集中!」と「会う話したい。」という同じフレーズではじまっているツイートが多い。同じフレーズが多いと共起ネットワークに表れやすくなってしまうので、これらのツイートは除外する(後の再分析前に別途Pythonで処理)。

さらに、「ぴえん」はすべてのツイートに含まれるため、後の再分析でKH Coderで使用しない語に設定する。また「言う」「思う」は分析に寄与しないと考えられるので同様に使用しない語に設定する。


KH Coderで再分析

もろもろの設定などをして再度共起ネットワークを作成した。

まずは、「みんなからの匿名質問を募集中!」と「会う話したい。」という同じフレーズではじまるツイートを除外した結果、対象ツイートは108001件となった。

続いて強制抽出する語の設定。KH Coderでは強制抽出する語のリストをテキストファイルから読み込める。次のようなテキストファイルを用意。

---cell---
ぴえんヶ丘どすこいの助
ぴえんヶ丘どすこい之助
ぴえんヶ丘どすこいのすけ
ぴえんこえてぱおん
ぴえん超えてぱおん
ぱおん

使用しない語のリストもテキストファイルから読み込める。「ぴえん」「言う」「思う」以外に抽出語上位の記号、ひらがな一文字もリストに加えておく。

---cell---
ぴえん
思う
言う
ー
()
え
あ
ま

再度共起ネットワークを作成する。設定は前回と同じ。


peingなどの投稿で使われた語が出現しなくなった。また、「ぴえん超えてぱおん」といった語が認識されていて、設定などの効果があったことが確認できた。ただ、ここで改めて抽出語を確認してみると、「ぴえん」と関係がありそうな抽出語52番目の「悲しい」が共起ネットワークに出現していない。これは「悲しい」と共起している語が多くないためと考えられる。


そこで多次元尺度構成法を使ってみる。さらに、気持ちを表す形容詞に注目しようと思うので形容詞B(ひらがなのみの形容詞)も対象に加えた。


気持ちを表す形容詞に注目すると、大辞林の説明と一致するのは緑枠の「悲しい」や「嬉しい」「楽しい」で、それに「辛い」を含めていいと思う。ただ、赤枠の「怖い」は「悲しみ」や「落胆」と関連づけるのは微妙。形容詞ではないが気になったのが「怖い」の右隣に布置された「怒る」。辞書の説明と一致していないように思えたが、確認すると「怒られた」という文脈で使われていることが多いので「落胆」に相当すると考えられる。全体としては、おおむね大辞林の説明と一致していると言えそう。